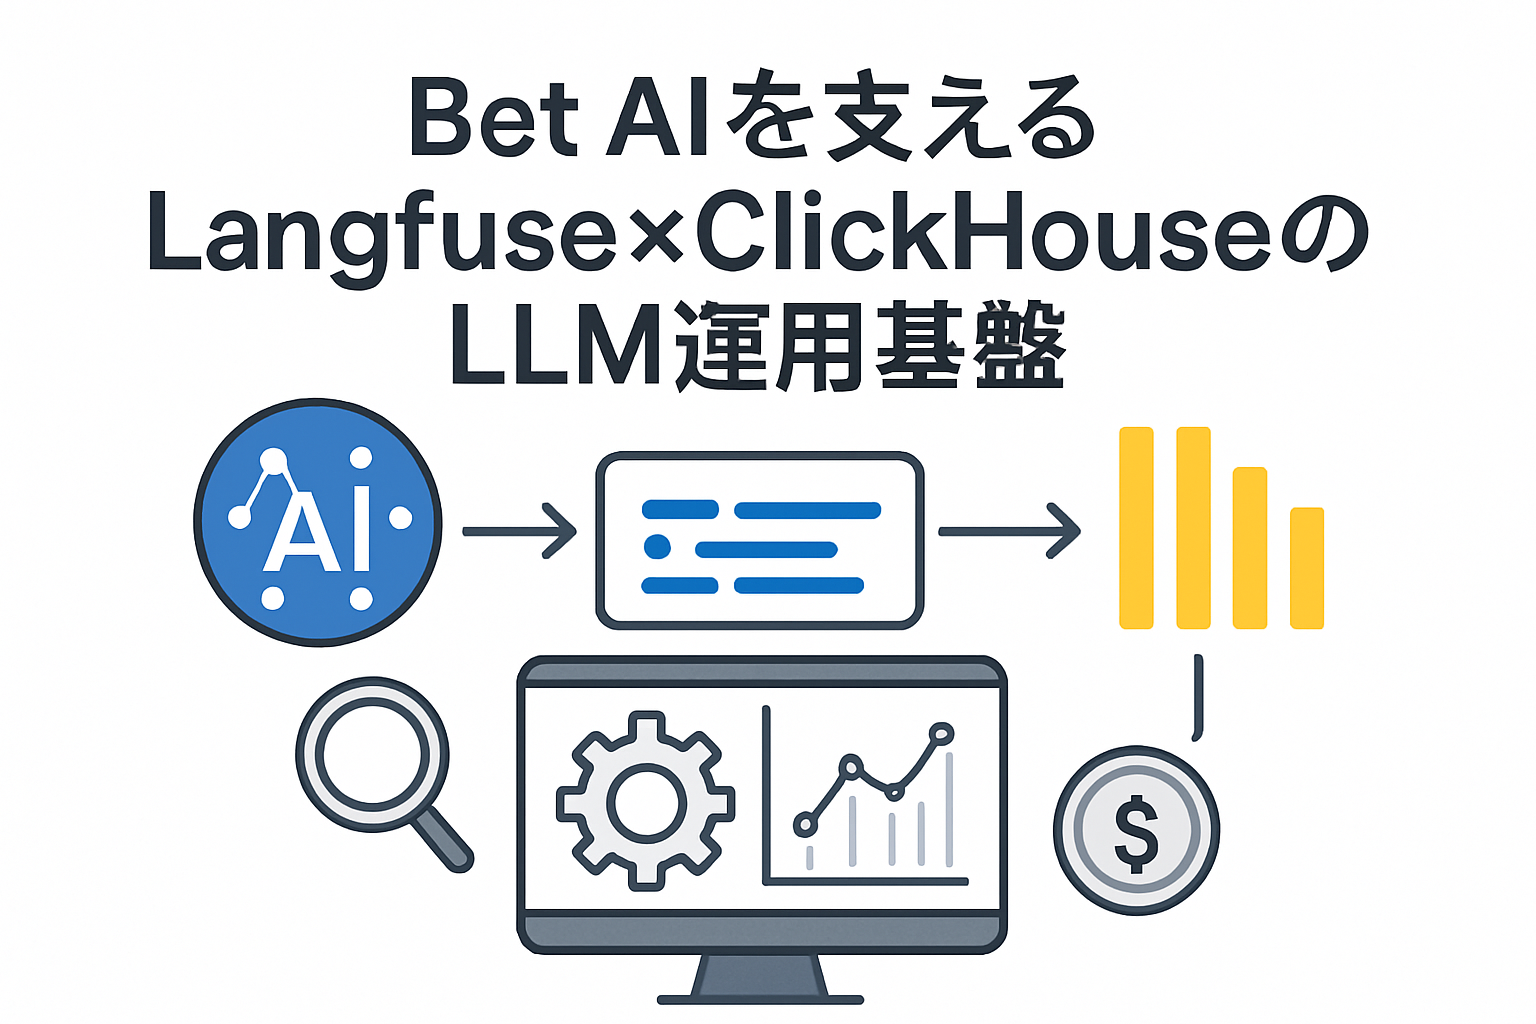
生成AIを業務やプロダクトへ組み込む際、モデルを呼び出すだけでは安定した運用にはつながりません。回答品質の評価、プロンプトの変更管理、推論コストの把握、障害発生時の原因調査までを継続的に行う必要があります。
本記事では、「Bet AI」を掲げるLayerXが選んだLLM基盤として紹介されたLangfuse×ClickHouseの構成に注目し、LLMアプリケーションの運用で何が重要なのかを解説します。個別の社内実装や最新の料金・提供条件を断定するのではなく、公開情報から読み取れる設計上の意義と、同様の仕組みを検討する際の実践的なポイントを整理します。
この記事で分かることは次のとおりです。
- LLM運用における可観測性の役割
- LangfuseとClickHouseを組み合わせるメリット
- ログ、評価、コストを分析する基本的な設計
- 導入手順と、セキュリティ・データ管理上の注意点
結論:LLMの実験と本番運用をつなぐ構成が重要
LLMアプリケーションでは、モデルやプロンプトを改善するための実験環境と、実際の利用状況を監視する本番環境を分断しないことが重要です。
Langfuseは、LLMの呼び出し状況をトレースし、プロンプト、入出力、レイテンシ、トークン使用量、評価結果などを確認するための可観測性プラットフォームです。一方、ClickHouseは大量のログやイベントを高速に集計・分析する用途に適したカラム指向のデータベースです。
この2つを組み合わせると、LLM専用の運用画面で個別のリクエストを調査しつつ、ClickHouseで長期間の利用傾向やコスト、ユーザー別の品質を分析するという役割分担を作れます。
| 構成要素 | 主な役割 |
|---|---|
| LLMアプリケーション | ユーザー入力を受け、検索、ツール実行、モデル呼び出しなどを行う |
| Langfuse | LLM処理のトレース、プロンプト管理、評価、デバッグを支援する |
| ClickHouse | 大量のイベントを蓄積し、品質・利用量・コストを集計する |
| ダッシュボードやBIツール | チームや経営層向けに指標を可視化する |
なぜLLMに可観測性が必要なのか
従来のアプリケーション監視だけでは不十分
一般的なWebアプリケーションでは、HTTPステータス、処理時間、エラーログなどを確認すれば、障害の切り分けができる場合があります。しかしLLMアプリケーションでは、HTTPリクエストが成功していても、回答内容が不正確だったり、検索結果を適切に利用できていなかったりすることがあります。
そのため、次のような情報を処理単位で追跡できる設計が必要です。
- ユーザー入力と最終出力
- 使用したモデルとモデルのバージョン
- プロンプトやシステム指示のバージョン
- RAGで取得した文書や検索結果
- ツール呼び出しの内容と結果
- 処理時間、トークン使用量、エラー
- 人手評価や自動評価の結果
品質改善には「結果」だけでなく「過程」が必要
回答が誤っていた場合、最終出力だけを見ても原因が分からないことがあります。検索対象の文書が不適切だったのか、プロンプトの指示が弱かったのか、モデルの選択が合っていなかったのかを調べるには、処理の各段階を記録する必要があります。
Langfuseのようなトレーシング基盤を利用すると、1回の処理を複数のスパンに分けて確認できます。たとえば「質問の分類」「検索」「再ランキング」「LLM呼び出し」「後処理」という流れを記録すれば、どの段階で品質や速度が低下したかを把握しやすくなります。
Langfuse×ClickHouseの役割分担
Langfuse:LLMアプリケーションの運用情報を扱う
Langfuseは、LLMの呼び出しを中心としたトレースや評価を扱うためのインターフェースとして利用できます。開発者は、特定ユーザーのリクエストや失敗した回答を確認し、プロンプトや処理フローを見直せます。
特に有用なのは、開発中の試行錯誤と本番データを同じ観点で比較できることです。モデルを変更したとき、評価スコアやレイテンシ、トークン量がどう変化したかを確認できれば、感覚だけに頼らない改善が可能になります。
ClickHouse:大量データの集計・分析を担う
LLMサービスの利用が増えると、リクエスト、トレース、評価、ユーザー、組織、モデルなどのイベントが大量に蓄積されます。ClickHouseは、このような分析向けデータを集計する基盤として検討できます。
たとえば、次のようなクエリを高速に実行する用途が考えられます。
- 日別・モデル別のリクエスト数
- ユーザーや部署ごとの推論コスト
- 入力トークンと出力トークンの推移
- p50、p95などのレイテンシ傾向
- 評価スコアが低いプロンプトや処理経路
- エラー率とエラーの種類
ただし、実際の性能はデータ量、テーブル設計、パーティション、インデックス、クエリ内容、運用環境によって変わります。「ClickHouseなら必ず高速」と断定するのではなく、想定するイベント量と分析要件をもとに検証することが大切です。
導入時の基本手順
1. まず記録するイベントを定義する
最初からすべてのデータを保存しようとすると、コストと個人情報のリスクが高まります。まずは、障害調査と品質改善に必要な最小限の項目を定義します。
- リクエストIDやトレースIDを決める
- モデル、プロンプト、アプリケーションのバージョンを記録する
- 入力・出力を保存する範囲を決める
- トークン量、レイテンシ、エラーを計測する
- RAGやツール実行の中間結果をどこまで記録するか決める
2. アプリケーションにトレーシングを組み込む
LLMを呼び出している箇所だけでなく、前処理、検索、外部API、後処理などにもトレースを設定します。処理全体を1つのログにまとめるより、工程ごとに分割した方が原因分析に役立ちます。
実装では、アプリケーション本体の処理と観測用コードを過度に密結合させないことが重要です。オブザーバビリティ基盤が一時的に利用できない場合でも、ユーザー向け機能まで停止しないよう、送信失敗時のタイムアウトや非同期送信を検討します。
3. 評価方法を決める
LLMの品質は単一の数値で表しにくいため、用途に応じた評価軸を設定します。たとえば社内文書検索では、回答の正確性、根拠文書との整合性、引用の有無、回答不能時の振る舞いなどを評価します。
- 自動評価:ルール、文字列判定、別のLLMによる評価など
- 人手評価:正確性、読みやすさ、安全性などを担当者が判定
- 運用指標:再質問率、解決率、エラー率、利用継続率など
自動評価は便利ですが、評価モデル自体の偏りや誤判定があります。重要な機能では、人手評価やサンプル監査を組み合わせてください。
4. ClickHouseで分析用のデータモデルを設計する
分析用途では、ログをそのまま保存するだけでなく、集計しやすい形に整える必要があります。代表的には、リクエスト単位の事実テーブルと、モデル、ユーザー、部署、アプリケーションなどの属性を持つテーブルに分けて考えます。
保存期間を決め、日付やテナントなど、実際の検索条件に合わせてパーティションや並び順を設計します。高頻度で参照する日次・週次の指標は、事前集計を用意するとダッシュボードの負荷を抑えやすくなります。
運用で見るべき主要な指標
| 分類 | 確認する指標 | 活用例 |
|---|---|---|
| 品質 | 評価スコア、正答率、再質問率 | プロンプトや検索処理の改善 |
| 性能 | 処理時間、モデル呼び出し時間、エラー率 | 遅延や障害の原因調査 |
| コスト | トークン量、モデル別利用量、推定費用 | モデル選択や利用制限の見直し |
| 安全性 | 機密情報の検出、拒否応答、異常な利用 | 情報漏えいや不正利用の監視 |
料金計算は、使用するLLM事業者や契約形態によって単価・算定方法が異なります。したがって、ダッシュボードには固定した費用だけでなく、入力・出力トークン、モデル名、利用時点の単価テーブルを分けて保存すると、料金改定時にも再計算しやすくなります。
注意点:便利さより先にデータ管理を設計する
プロンプトと回答には機密情報が含まれ得る
LLMのトレースには、ユーザーの個人情報、社内文書、認証情報、取引情報が含まれる可能性があります。ログ基盤へ送信する前に、保存対象とマスキング方針を決めてください。
- メールアドレス、電話番号、氏名などをマスキングする
- パスワード、APIキー、アクセストークンを記録しない
- 機密文書の全文ではなく、ハッシュや識別子だけを保存する方法を検討する
- テナントや部署ごとのアクセス制御を行う
- 保存期間と削除手順を明文化する
ログの完全性とプライバシーは両立させる
詳細なログは障害調査に役立つ一方、保存量と漏えい時の影響を増やします。開発環境では詳細なデータを使い、本番環境ではマスキング済みのサンプルやメタデータを中心にするなど、環境ごとにポリシーを分ける方法があります。
また、ログの閲覧権限を広くしすぎると、通常の業務では不要な個人情報まで見られてしまいます。SSO、ロールベースアクセス制御、監査ログ、ネットワーク制限などを組み合わせてください。
ベンダーロックインと運用負荷を確認する
LangfuseとClickHouseを採用する場合でも、データ形式やSDKに依存しすぎると、将来の移行が難しくなる可能性があります。イベントスキーマ、エクスポート方法、バックアップ、障害時の再送、バージョンアップ手順を事前に確認しておきましょう。
また、セルフホスト型の構成を選ぶ場合は、データベースの監視、アップデート、バックアップ、権限管理などが自社の運用責任になります。採用判断では、ソフトウェアの機能だけでなく、担当チームが継続的に管理できるかを評価してください。
Langfuse×ClickHouseが向いているケース
- LLMアプリケーションの処理過程を詳細に調査したい
- プロンプトやモデルの変更を定量的に比較したい
- 大量の利用ログを長期間分析したい
- 組織別・アプリ別・モデル別にコストを把握したい
- 自社のセキュリティ要件に合わせてデータ基盤を設計したい
一方、検証段階でリクエスト数が少なく、単純なエラーログだけで十分な場合は、最初から大規模な分析基盤を構築する必要はありません。将来のデータ量と品質改善の要件を見積もり、段階的に導入する方が現実的です。
よくある質問
LangfuseとClickHouseはどちらか一方だけでも使えますか?
可能です。ただし、両者は主な役割が異なります。LLMのトレースや評価を中心に始めるならLangfuse、イベントの大規模集計や分析基盤を重視するならClickHouseを検討します。必要な機能と運用体制に応じて選んでください。
LLMの入力と出力はすべて保存すべきですか?
すべて保存する必要はありません。個人情報や機密情報を含む可能性があるため、マスキング、保存期間、アクセス権限を先に設計します。品質評価に必要なサンプルだけを保存する方法もあります。
導入前に何を検証すべきですか?
代表的なトラフィックを使い、ログ送信によるレイテンシ、保存量、集計速度、障害時の挙動、権限管理、データ削除を確認します。料金や提供状況は利用するサービスの公式情報で確認し、契約条件を含めて判断してください。
まとめ
「Bet AI」を掲げるLayerXのLLM基盤というテーマから見えてくる重要な点は、生成AIを本番で活用するには、モデル選びだけでなく観測・評価・分析の仕組みが必要だということです。
LangfuseはLLM処理のトレースや評価、ClickHouseは大量イベントの集計・分析という形で役割を分担できます。導入する際は、次の順番で検討すると進めやすくなります。
- 改善したい品質・性能・コストの課題を定義する
- 記録するイベントと個人情報の取り扱いを決める
- 小規模な処理フローでトレーシングを検証する
- 評価指標とダッシュボードを整備する
- データ量、権限、バックアップ、運用負荷を確認して本番展開する
まずは1つのLLM機能を対象に、回答品質と処理コストを可視化するところから始めるのが現実的です。最新の機能、料金、対応環境は、Langfuse、ClickHouse、利用するLLMサービスの公式ドキュメントで確認してください。
コメント